
上下文窗口
每个模型一次能读多少内容是有限的,这叫上下文窗口。ZettCode 一次请求里发的东西都在争这份预算:指令、 工具的 schema、你说的话、模型说的话、每个工具的输出,以及之前压缩留下的摘要。没有任何东西能超出它。
/context 打开一个页面,讲的是最新那一次请求:窗口有多满、离压缩还有多远、里面的 token 从哪里来。状态行里的 ctx 是同一个测量,只是缩短了。
/context它画的是模型真正收到的上一次请求,不是你屏幕上的对话。你打了字但还没发出去的请求不在里面;工具调用产生的 内容,只有发回给模型之后才在里面。Esc 关闭页面,请求进行中打开也无妨:它只读,不改任何东西。
如果页面显示 No request yet,说明这个会话还没发过请求。发一条消息,或者恢复一个发过的会话。
读懂这张图
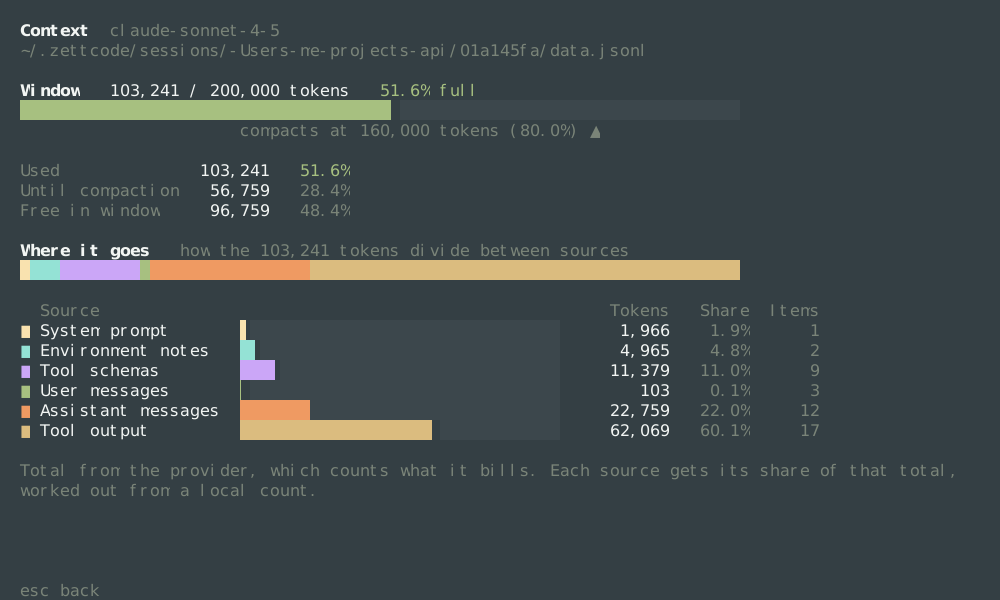
窗口
Window 103,241 / 200,000 tokens 51.6% full第一个数是最新请求带了多少;第二个是模型配置的窗口(config.toml 里的 context_window);第三个是两者相除的结果。这里的 51.6% 表示这条请求占了模型容量的一半多一点。
下面的条就是同一个数字按比例画出来,而它的颜色说的是危险程度,不是大小:离压缩点很远时是绿色, 到压缩点的四分之三处变琥珀色,到它就变红。▲ 标出请求会被总结、改短之后发送的位置。
compacts at 160,000 tokens (80.0%) ▲这个位置是窗口的 compact_percent —— 这里是 80%,也就是 200,000 中的 160,000。到达它并不意味着窗口满了: 这是 ZettCode 不再继续加、先压缩的那条线,这样一长轮对话就不会以供应商的“上下文超长”报错收场。 见下面的压缩。
移动这条线
按键提示上面那一行 Compress at 是一根带旋钮的滑轨:在窗口的百分之几处压缩。← 和 → 每次把旋钮移动 5%(点一下滑轨则直接送到那里)。 旋钮是一个圆点,沿着滑轨滑过去,滑轨从平静的绿色经过琥珀色到红色;仪表下面的 ▲、数字和 Until compaction 一行都跟着一起移动, 所以你在决定之前就能看到新位置对眼前这条请求意味着什么。按 Enter 之前什么都不会写;Enter 会把 compact_percent 写进这个模型在 config.toml 里的条目,并对下一条请求生效;Esc 保持原样。文件不能编辑时,这次修改只对本次运行有效, 并会说明没有被记住。开启“减少动态效果”时旋钮直接出现在目标位置。
接着是同一份预算的三个数字,各自占窗口的比例:
| 行 | 是什么 |
|---|---|
Used | 这条请求的 token,和 Window 行第一个数是同一个。 |
Until compaction | 在请求被总结之前还能加多少。这是最该看的一个数:它才是真正的余量。 |
Free in window | 离模型完全装不下这条请求还剩多少。 |
Until compaction 56,759 和 Free in window 96,759 正好差标记处的 40,000 个 token,因为它们回答的是两个问题: 还有多少就该总结了,还有多少就该被拒绝了。
token 花在哪了
Where it goes   how the 103,241 tokens divide between sources
████████████████████████████████████████████████████████████████████████
一根条,按下面的颜色分给各个来源,整条请求一眼看全。每一段下面各有自己的一行,用这一行自己的刻度再画一根条 —— 小到在顶部条里看不出来的来源,在这里仍然看得见。
| 来源 | 装的是什么 |
|---|---|
System prompt | ZettCode 自己的指令:怎么用工具、工作目录、日期。只设一次,而且故意保持稳定,好让供应商缓存它。 |
Environment notes | 之后的 system 消息:你的项目指令(AGENTS.md 之类),以及 ZettCode 在会话开始时加的说明。 |
Tool schemas | 这条请求提供的每个工具的定义 —— 名字、描述、参数 schema。九个工具就是九条,用不用都在。 |
User messages | 你输入的内容,包括用 /btw 问的问题。图片按固定笔数计,而不是按文件大小。 |
Assistant messages | 模型写的内容:回答、供应商返回的推理,以及它带参数的工具调用。 |
Tool output | 工具返回的内容:文件正文、命令输出、搜索结果。通常是最大的一行,也是长得最快的一行。 |
Compaction summary | 之前某次压缩留下的、代替更早对话的摘要,一条。只有压缩过之后才有。 |
Items 是 Tokens 加总时的条数:消息、工具定义、摘要。它不是对话轮数,也不代表大小 —— 一条工具结果可能比 二十条消息都大。
Share 是每个来源占已统计内容的比例,所以各行加起来是 100%。注意这意味着什么:Tool output 60.1% 和 62,069 个 token 不是占窗口的 60.1%,而是占被统计的这条请求的 60.1% —— 这一节讲的正是这件事。窗口本身的 百分比只在 Window 那一行。
脚注:这是谁的数
最后几行说明总量从哪里来,这决定了各行该怎么读:
Total from the provider, which counts what it bills. Each source gets its share of that total,
worked out from a local count.
这是正常情况,意思是:
- 总量是供应商对收到的这条请求自己的计数,也就是它计费的数;
- 来源之间的拆分是 ZettCode 本地统计出来的,因为没有供应商会上报明细;
- 所以每个来源显示的是它占供应商总量的那一份 —— 各行把 103,241 正好分完 —— 条上的数是比例,不是测量值。
本地统计分得清谁比谁大,但绝对大小不精确:它用一种 tokenizer,模型可能用另一种。这就是为什么页面从不把本地 总量单独当成一个数字给你看。
接近上限的请求
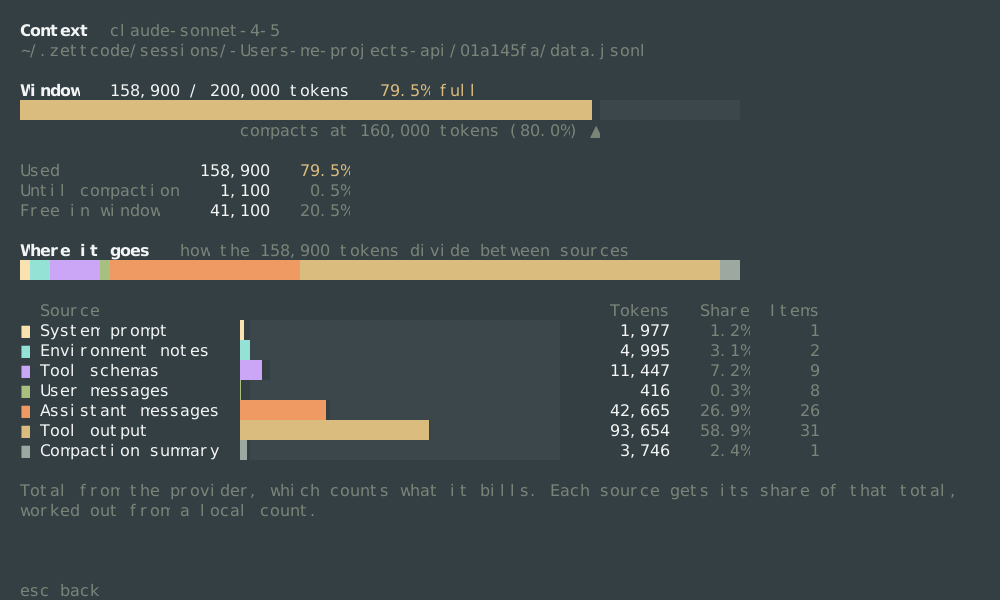
这是同一个页面,在一长轮对话的较晚阶段。计量条是琥珀色,Until compaction 只剩 1,100,而且多出了第七个来源: Compaction summary —— 早先已经由摘要代替的对话,3,746 个 token 装着过去几千个 token 的内容。 Assistant messages 和 Tool output 都长大了,Tool output 现在是 93,654 个 token —— 几次长读取和测试运行。
当下一次请求会越过 80.0% 时,ZettCode 不再照发,而是先压缩:较早的部分变成一条摘要,触发线的最后四分之一 原样保留,请求变短之后再发出。见压缩。
刚恢复的会话
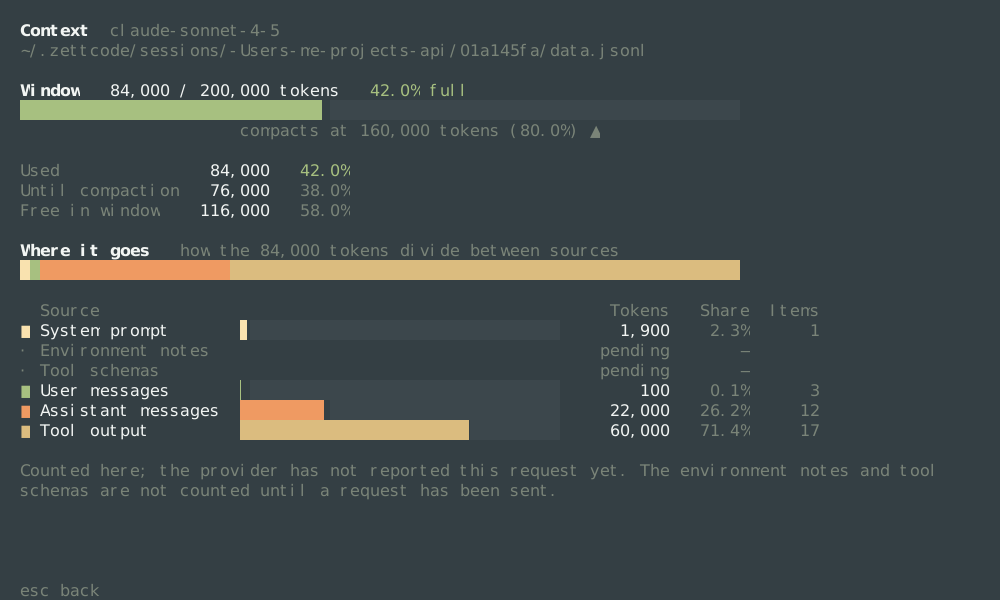
有两行写着 pending,前面的色块是点而不是方块,脚注也不一样:
Counted here; the provider has not reported this request yet. The environment notes and tool
schemas are not counted until a request has been sent.这个会话是恢复来的,在这个进程里还没发过任何请求。Tool schemas 和 Environment notes 是在组装请求的那一刻 生成的 —— 它们属于请求,不属于对话 —— 所以在发出请求之前无从得知,ZettCode 也不会去猜。总量是本地统计的, 而不是供应商上报的,而且因为缺了两个来源,各行加起来不等于窗口。
把它当作下限来读:它已经装了 42.0%,等那两行回来会再大一些。发一条消息,再运行一次 /context,就能看到完整 的样子。
这些数字,以及它们不是什么
| 问题 | 答案 | 在哪里 |
|---|---|---|
| 窗口有多满? | 请求 ÷ 窗口 | Window … 51.6% full,以及状态行的 ctx |
| 离摘要还有多远? | 压缩点 ÷ 窗口 | compacts at 160,000 tokens (80.0%) ▲ |
| 上下文花在哪了? | 来源 ÷ 已统计 | Share 列,加起来 100% |
| 这是谁的计数? | 供应商上报了就用它的 | 脚注 |
| 拆分精确吗? | 不精确:一种 tokenizer 得出的比例,放进供应商的总量里 | 脚注 |
两种百分比不要混淆:状态行的 ctx 51.6% 说的是窗口,而某一行的 60.1% 说的是请求。一行可以占请求的 60%, 同时只占窗口的 30%。
脚注里出现 About four characters to a token,说明没有可用的 tokenizer —— 它的词表第一次要联网下载 —— 拆分用的是经验法则。图的形状仍然是对的,行里的绝对 token 数是近似值。
某一行大得意外
那一行就是该看的地方,几种大的都有已知的原因:
| 行 | 常见原因 | 怎么办 |
|---|---|---|
Tool output | 读了很长的文件、命令输出太啰嗦、搜索结果太大 | 按范围读而不是整个文件,收窄命令输出,或者让 /compact 把较早的结果换成摘要 |
Tool schemas | 提供的工具太多:每个 MCP 服务器、每个 skill、每个内置工具 | 关掉不用的([mcp]、[skills]);schema 每条请求都要付,用不用都在 |
Assistant messages | 回答很长,以及供应商返回的推理 | 没出问题,这就是对话本身。该动的是压缩 |
Compaction summary | 摘要本身很大 | 压缩一次出现属正常;如果每次压缩都在变大,就该压得更晚而不是更勤 |
Environment notes | 项目指令很长,或者 skills 索引很大 | 精简指令,它们每条请求都会读 |
压缩
当最新一次请求将要越过触发线时,对话会在发出之前被总结:较早的部分变成一条摘要消息,触发线的最后四分之一 原样保留,所以模型保住了眼前的上下文,只丢掉已经说过的内容。/compact 可以立刻做这件事。
摘要是作为一种独立的记录存下来的,而不是删除。这就是为什么对话里会以 Conversation checkpoint 收尾, 为什么会话列表仍然准确,以及为什么昨天压缩过的会话今天还能正确恢复。手动触发时只有最后一轮会原样保留, 而自动压缩会留下触发线的四分之一。
压缩的代价
总结本身是一次模型调用,所以要花几秒钟 —— 期间对话里会显示 Compacting。早做比晚做好:不然你就得在自己 正忙着的时候面对接入点报错。如果摘要并不比原文更短,ZettCode 会直接说明并保留原文。
对话进行了几轮,或者读过很大的文件之后,可以依次尝试:
/context
/compact
/context
每次用 Esc 关闭上下文面板,再输入下一条命令。/compact 立即开始生成摘要,期间显示带动画的 Compacting。 对比前后报告:较早的内容由摘要替代,近期工作上下文仍然保留,而 Tool output 减少的比摘要增加的更多。 它不是 /clear:压缩改变的是后续发给模型的内容,不只是屏幕上可见的对话。
如果最新的 checkpoint 已经覆盖当前对话,再手动压缩会被拒绝并提示。先继续对话,再考虑压缩。摘要可能省略细节; 需要准确原文时,让模型重新读取对应文件。
模型也可以自己请求压缩,前提是你允许:那就是自我压缩, 它永远不会动当前这一轮。
让请求保持小
压缩是最后的手段;一直长不大的请求根本用不着它。
- 只读需要的部分。 读一段行比读整个文件好,窄命令比宽命令好。工具输出在被压缩之前,每条请求都要付一次。
- 发一个版本,不是三个。 一次重写大段内容的编辑,会让旧文本留在对话里直到被压缩。
- 关掉不用的工具。 你启用的每个 MCP 服务器、作用域里的每个 skill,都会给每条请求加上 schema; 见 Skills 与 MCP。
- 新任务就开新会话。
/new不要钱;一个已经跑偏、帮不上忙的对话要钱。 - 让稳定的部分保持稳定。 每条请求最前面的 system prompt 和工具列表正是供应商缓存的内容,所以同一个前缀 比重新排列过的更便宜。这就是状态行上的
cached和/usage里的cached列。