
Token 用量
/usage 打开一个页面,看这个项目花了多少:项目里的每个会话、用过的每个模型、用过的每一天。它读的是你 本机已经存下的对话,不是账单,也不是实时计数器。打开一次,一小时后还是同样的数,直到某个会话又写入了新东西。
/usageTab 或 1、2、3 在三个视图之间切换:Models、Sessions、Calendar。Esc 或 q 关闭页面。 页面统计的是你启动时所在的项目,不是整台机器:zettcode -w ~/projects/api 只数那个项目的会话。
token 是什么,这里数的是哪些
token 是模型读取和计费的单位:英文大约四个字符,不到一个单词。页面上每个数字都是 token 数,而且每个都 是供应商为某条回复上报的计数 —— 这里没有任何估算。
| 页面上的词 | 数的是什么 |
|---|---|
in / input | 发给模型的每个 token。对话每轮都会重新发送一遍,所以更早的消息每次都会被再数一次:这个数比对话本身增长快得多。 |
out / output | 模型生成的每个 token,包含推理。 |
cached | input 中由供应商自己的缓存作答、因而计费更便宜的那部分。它是 占 in 的比例,不是另一个计数。 |
reasoning | 供应商上报时,out 中算作模型思考的那部分。同样是 out 的一部分。 |
| tokens | in + out。缓存与推理已经包含在这两项里,不会重复计算。 |
| requests | 模型调用次数:对话每轮一次,加上压缩产生的调用。 |
| sessions | 计入的对话数,在 /resume 里各占一行。 |
超过一千的计数会缩写:740K 是 740,000,3.14M 是 3,140,000,再往后是 B 和 T。一千以下原样写出。
顶部那一行
三个视图上方都是这一行,它统计整个项目:
All models 3.14M tokens in 2.98M out 159K cached 61.07% 43 requests · 3 sessions从右往左读就是全部:3 个会话里一共有 43 次模型调用,其中生成了 159,000 个 token;发出的 2,980,000 个 token 里有 61.07% 由供应商缓存返回,所以输入的实际花费比它的体积看起来要低。
cached 61.07% 总是保留两位小数。如果这里显示的是破折号,说明供应商从未为计入的输入上报过缓存读取, 很多本地和网关接入点都是这样。
Models
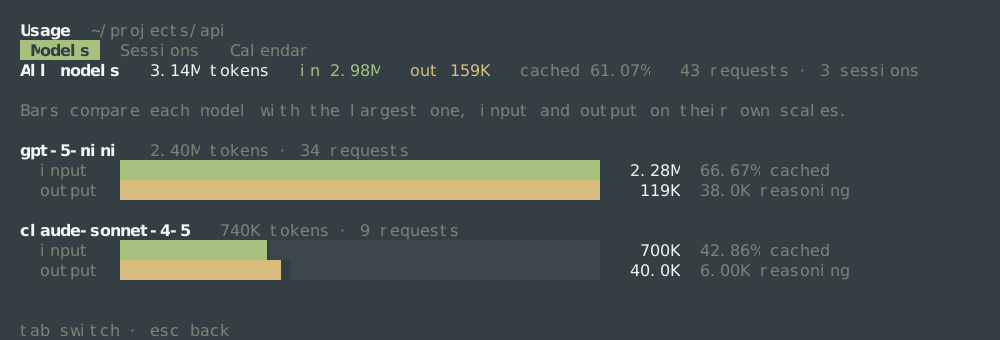
每个模型一块,最大的在前。条形图拿每个模型和最大的那个相比,而且 input 和 output 各用各的刻度: 对任何模型来说 output 都只是 input 的一小部分,共用一个刻度会把它画得几乎看不见。上图里 gpt-5-mini 发出的 input 最多、生成的 output 也最多,所以它两条都是满的,另一个模型的条则按自己的比例短下去。
| 这行 | 说的是什么 |
|---|---|
gpt-5-mini 2.40M tokens · 34 requests | 这个模型发了多少、生成了多少,花了多少次调用。 |
input 条 | 发出的 token,以发得最多的模型为刻度。2.28M 是这个模型自己的数。 |
66.67% cached | 这个模型的 input 中由供应商缓存作答的比例。 |
output 条 | 生成的 token,以生成得最多的模型为刻度。119K 是它自己的数。 |
38.0K reasoning | 这个模型的 output 中被上报为推理的那部分。 |
只在一次小任务里用过一次的模型也会有一块,因为早先一个图省事的选择可能占了整月的大部分。
Sessions
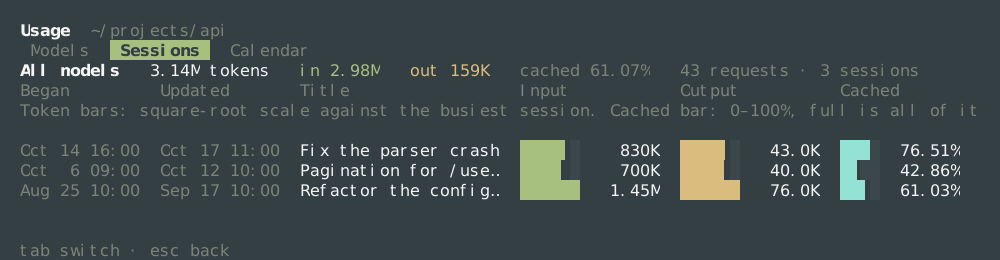
每个会话一行,最后变更的在前,和 /resume 的顺序一致。
| 列 | 是什么 |
|---|---|
Began | 这个会话第一条被计入的回复写于何时。 |
Updated | 最后一条写于何时。行就是按它排序的。 |
Title | 会话名,没有就是 (untitled)。窄页面会用 … 截断标题,而不是放弃一个数字。 |
Input | 这个会话发出的 token,带条。 |
Output | 它生成的 token,带条。 |
Cached | 它的 input 中来自缓存的比例,带一根 0–100% 的条:满格表示每个输入 token 都来自缓存。 |
token 条用平方根刻度,所以一个小上千倍的会话在大会话旁边依然看得见;旁边的数字是精确的。 缓存条是普通的 0–100%,所以两行可以直接比较,条和旁边的百分比说的是同一件事。
缓存这一列值得多看两眼。你反复回来的长会话往往命中率高,因为它的开头一直没变、一直被缓存; 一个总在别处结束的地方开始的短会话往往偏低。切换模型、压缩、长时间空闲都会把它拉低。没有“好的数值”: 拿一个会话和它自己改变之前比,不要和旁边那一行比。
窄终端按固定顺序放弃列:先放弃条形图,然后是缓存列,再是时钟,最窄时只留 Updated —— 行就是按这个时间排序的。
Calendar
一张像 GitHub 贡献图的网格:一列是一周,周日到周六;一行是一个星期几;一个方块是一天, 深浅表示那一天花掉的 token,input 加 output。
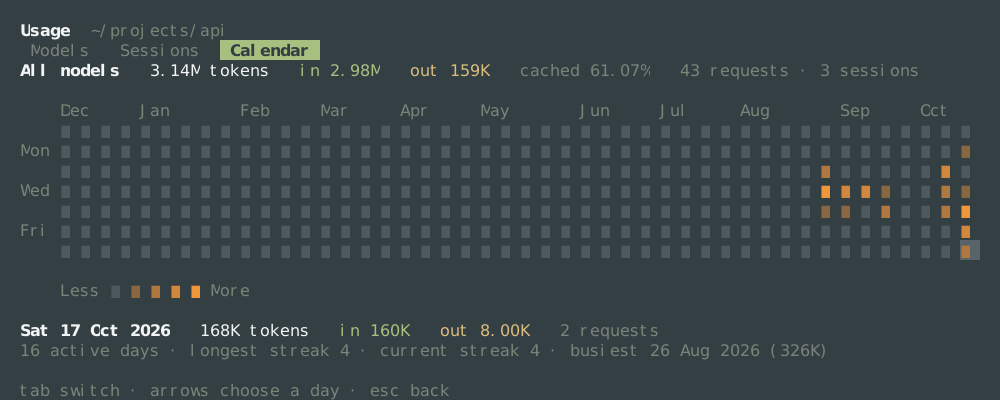
四种深浅加一个空白覆盖了每一天,而深浅是相对你自己的天,不是固定的数值:分界点是“用过的天”的四分位。 一天花一百万 token 的人和一天花一千的人,都会得到一张有深有浅的图 —— 这正是重点:网格画的是工作的形状, 不是它的规模。空白格是没花任何 token 的天;未来的天根本不画。
网格下面五格图例写着 Less … More,用的就是和日期同样的五种深浅。先看图例再看网格:在某个配色里 很显眼的深浅,换个配色可能很淡,而空格子就紧挨着最浅的那一档。
网格下方:
Sat 17 Oct 2026   168K tokens   in 160K   out 8.00K   2 requests
16 active days · longest streak 4 · current streak 4 · busiest 26 Aug 2026 (326K)- 选中的那一天是用方向键移到的,这一行说明它花了多少、怎么分的、用了几次调用。没有用量的天显示
nothing spent。 - active days 是有用量的天数,全部历史。
- longest streak 是最长的一段连续使用天数。
- current streak 是一直延续到今天的那段。如果今天还没用、但昨天用了,这段不算断:就按现状显示, 因为这一天还没过完。
- busiest 指出花费最高的那一天和它花了多少。
← → 把选中的天按周移动,↑ ↓ 按天移动,下面的行跟着变。终端越宽显示的周数越多,最多 53 周,即一年。
数了什么,没数什么
- 一条回复只数一次,记在最初写下它的会话里。
/fork会把对话连同每条回复的花费复制到新会话,所以 fork 之后只显示 fork 之后花的,更早的回复留在原会话里。没有任何东西被计算两次。 - 子代理的会话不计入。 那是模型为了完成一部分任务而开的会话,不是你进行过的对话,它的 token 已经算在 发起它的那一轮里了。
- 一天是你所在时区的一天。 晚上十一点半写下的回复算在你看到的那一天,而不是 UTC 的那一天。
- 旧版本写下的会话也计入,只要它的回复带着用量数据;没有用量的回复不会凭空加一个估计值。
- 压缩也算。 总结上下文本身是一次模型调用,所以它会出现在请求数和 token 里。
这些数字存在哪里
在一个历史很长的项目里第一次打开 /usage 会读遍所有对话,如果有几个 GB,可能要花几秒钟。之后它会在该项目 的会话目录里放一个小小的 usage.json —— 在 ~/.zettcode/sessions 下,每个项目一个文件夹 —— 以后每次 /usage,无论这次还是下次启动,都只读新增的部分。这个文件只是个捷径:删掉它,下次 /usage 会从对话里 重新建好。
/resume 面板也会显示每个会话的条目数、token 数和缓存命中率。缓存命中率和这里一样保留两位小数,每个数字列有自己的 颜色:缓存越多地作答了输入,缓存列就越亮,所以一列很弱的缓存一眼就能看出来。这些合计存在旁边另一个小得多的文件 sessions.json 里:每个会话一行很短的记录,所以打开面板时,只要对话没有变化,就既不读索引也不读对话。它同样只是 捷径,删掉不会丢任何东西。
因为数字来自已存的对话,页面讲的是项目,不是进程:你上周关掉的会话也在上面,你正在用的这个会话会边用边加进去。
这个页面,还是状态行?
它们回答不同的问题,用的是不同的数字。
/usage | 状态行 | |
|---|---|---|
| 范围 | 项目里的每个会话 | 只有这个会话 |
| 时间 | 到目前为止所有存下的内容 | 从这个会话开始 |
cached | 整个项目 input 的比例 | 这个会话 input 的比例 |
| 何时增长 | 会话保存一条回复时 | 回复正在到达时 |
所以状态行里看着不大的会话,在这个页面上仍可能是很大的一行;而顶部数字很大的项目,你面前可能只是一个小 会话。两者都不是账单:实际收费看供应商自己的控制台。↑ ↓ cached tok/s ctx 这几个数见 读懂状态行。
看起来不对的时候
| 看到的现象 | 意味着什么 |
|---|---|
| 页面是空的 | 这个项目还没有任何会话留下带用量数据的回复。一个只发了问题、在回答之前就被停下的会话什么都没花。 |
cached — | 供应商没有上报缓存读取。页面没问题,只是没有可算的比例。 |
| 数字比对话本身大得多 | 输入每次发送都会被重新数一次。长对话发很多次,数是会乘起来的,这就是这个数字的意义。 |
| 这个页面和供应商控制台对不上 | 统计 token 没有唯一的方法。页面重复的是供应商报给 ZettCode 的数;别的工具里的会话不在这里。 |
| 某天看着太浅或太深 | 深浅是你自己有用量的天的四分位,所以多加一个很重的天,其他天的深浅会跟着重排。 |